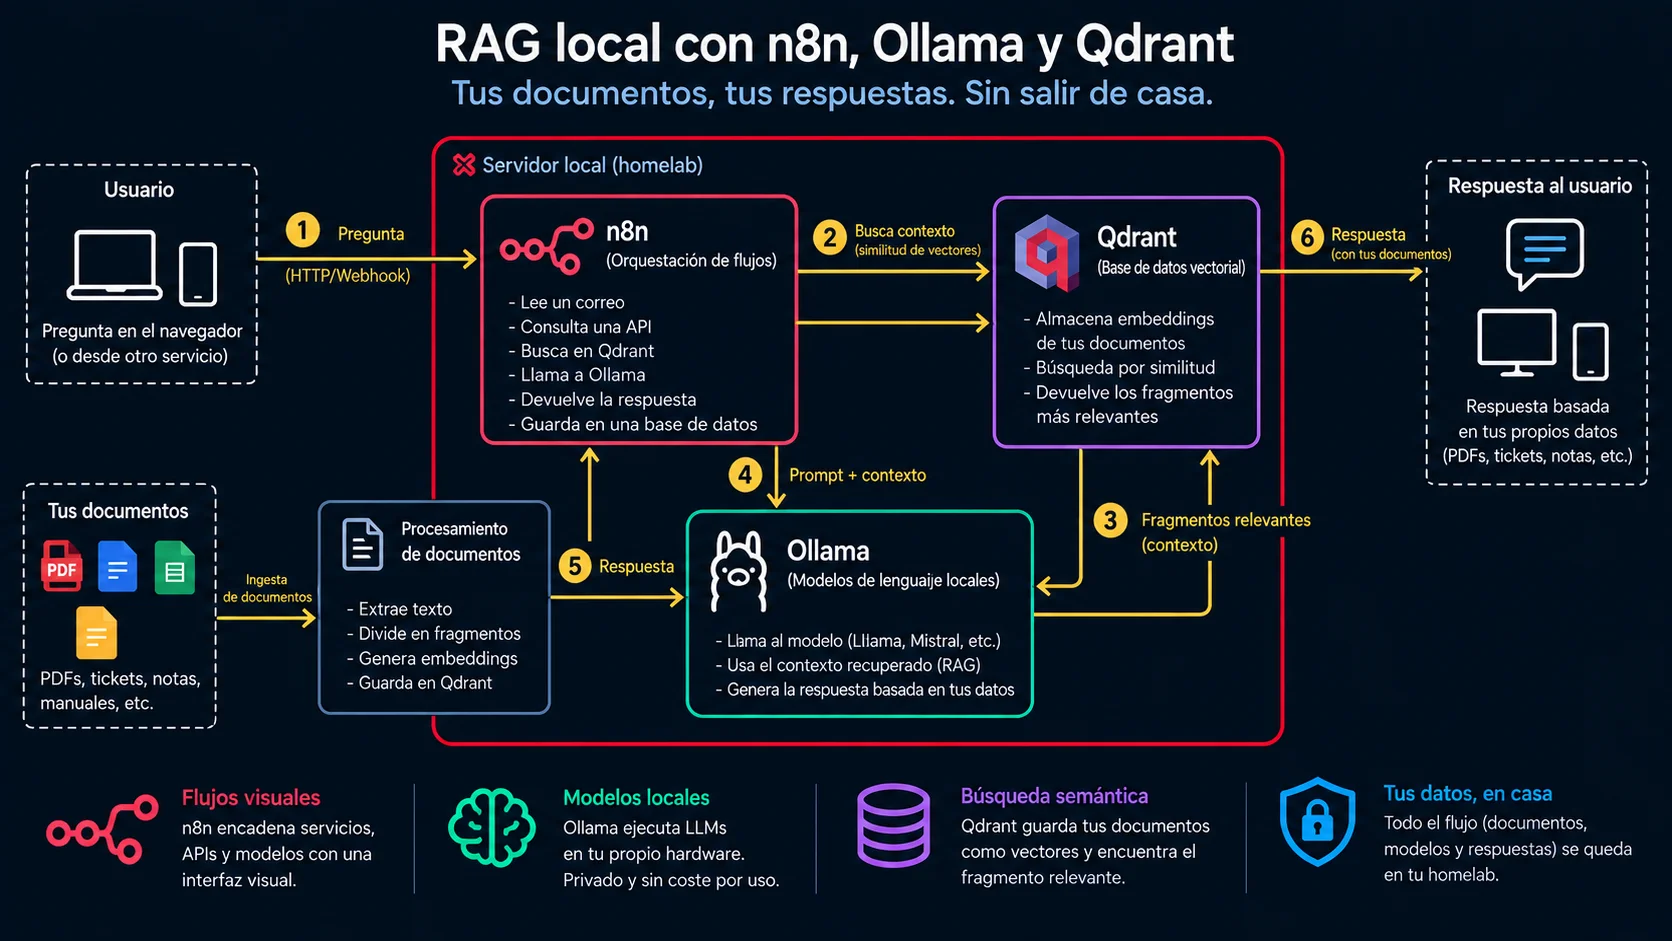
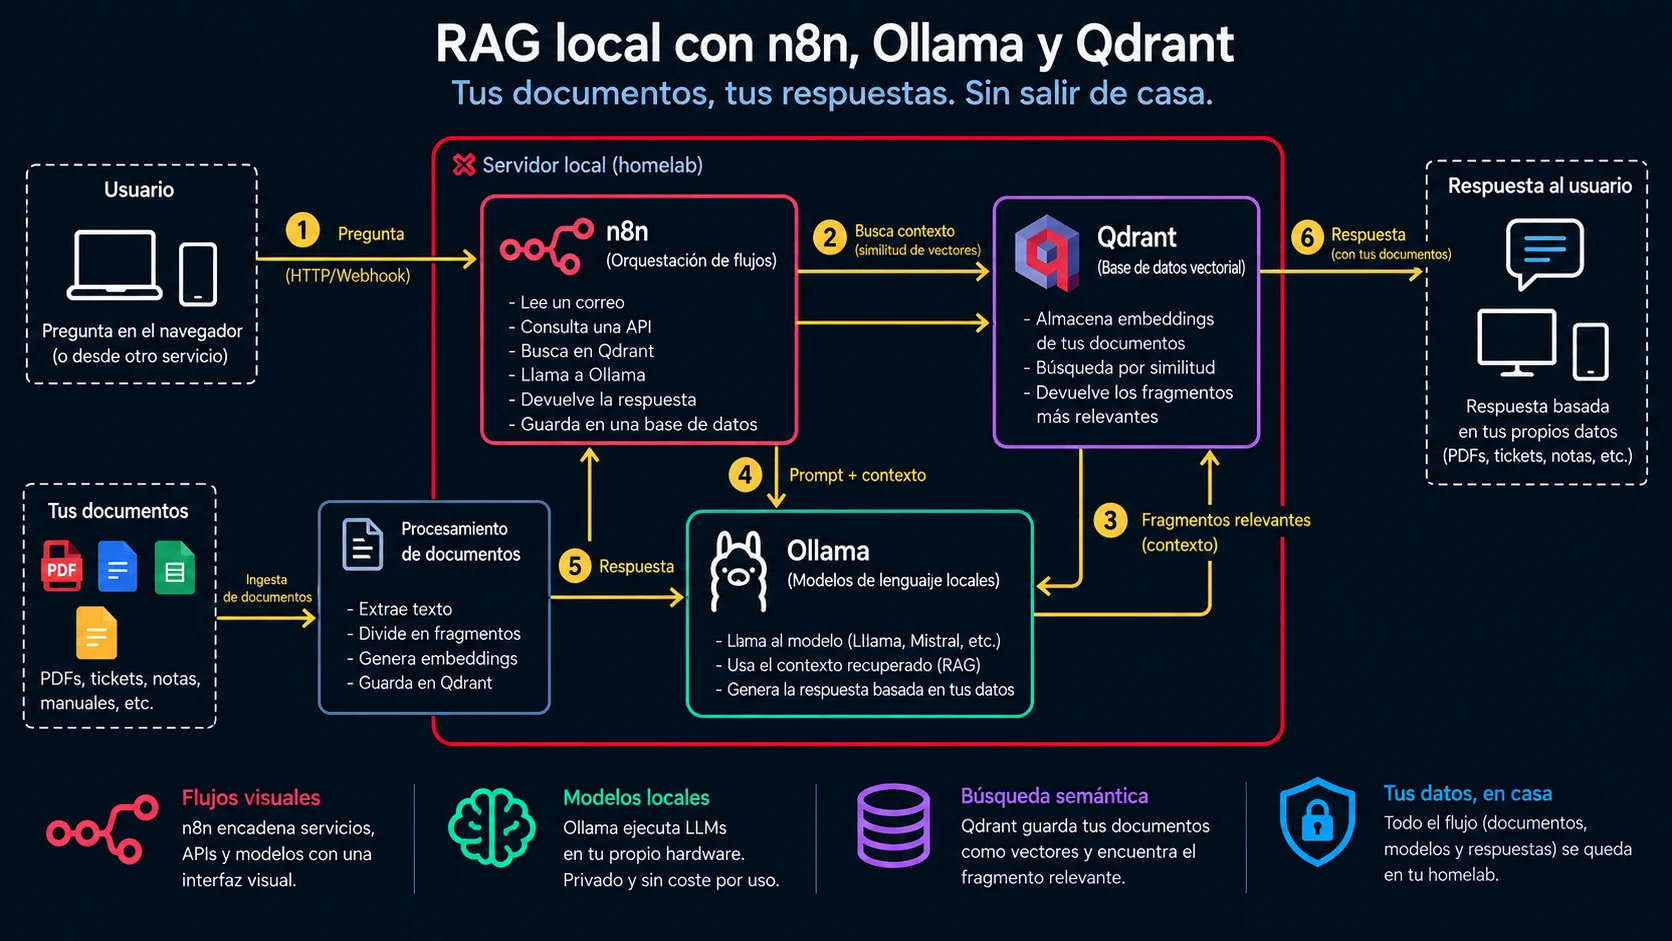
n8n encadena pasos (leer un correo, consultar una API, escribir en una base de datos) con una interfaz visual; Ollama ejecuta modelos de lenguaje en tu propio hardware; Qdrant guarda los documentos como vectores para que el modelo encuentre el fragmento relevante antes de responder, en vez de inventárselo. Juntos montan un flujo de RAG (Retrieval-Augmented Generation) casero: pregúntale a un flujo de n8n sobre tus propios PDFs, tickets o notas, y responde con lo que de verdad hay en ellos.
Automatización con IA local en tu homelab: n8n + Ollama + Qdrant
Objetivo
Montar flujos de automatización que consultan y razonan sobre tus propios documentos con un modelo de lenguaje local, sin mandar nada a un servicio en la nube.
2 de octubre de 2026por Álvaro Fraguas Bravo
Componentes
Base · Host
Servidor con Docker
ya deberías tenerlo
Base de datos de n8n
PostgreSQL
1 GB1 vCPU10 GB
Orquestador de automatizaciones
2 GB1 vCPU5 GB
Base de datos vectorial
2 GB1 vCPU10 GB
Servidor de modelos locales
8 GB4 vCPU30 GB
Total a reservar (suma de los componentes con recursos propios)
13GB RAM7vCPU55GB disco
Cómo se conecta
Haz clic para ampliar
Ensamblaje
Desplegar PostgreSQL y Qdrant
services: postgres: image: postgres:16 environment: - POSTGRES_USER=n8n - POSTGRES_PASSWORD=cambia-esto - POSTGRES_DB=n8n volumes: - ./postgres:/var/lib/postgresql/data qdrant: image: qdrant/qdrant:latest volumes: - ./qdrant:/qdrant/storage ports: - "6333:6333"Desplegar Ollama y descargar un modelo
docker run -d --name ollama -v ollama:/root/.ollama -p 11434:11434 ollama/ollama
docker exec -it ollama ollama pull llama3
docker exec -it ollama ollama pull nomic-embed-text
Descargas dos modelos: uno de chat (el que redacta la respuesta) y uno de embeddings (el que convierte cada fragmento de texto en un vector para Qdrant). Si tu servidor no tiene GPU, Ollama funciona igual en CPU — más lento, pero funcional para volúmenes de uso personal.
Desplegar n8n conectado a Postgres
n8n: image: n8nio/n8n:latest environment: - DB_TYPE=postgresdb - DB_POSTGRESDB_HOST=postgres - DB_POSTGRESDB_USER=n8n - DB_POSTGRESDB_PASSWORD=cambia-esto ports: - "5678:5678" volumes: - ./n8n:/home/node/.n8nMontar el flujo de RAG en n8n
Con los tres servicios arriba, el flujo típico en n8n tiene cuatro piezas: un disparador (webhook, o un nodo de lectura de ficheros para indexar documentos), un nodo HTTP Request contra Ollama (/api/embeddings) para convertir el texto en vector, un nodo HTTP Request contra Qdrant (/collections/.../points/search) para traer los fragmentos más parecidos a la pregunta, y un último nodo HTTP Request contra Ollama (/api/generate) que redacta la respuesta usando esos fragmentos como contexto. n8n no trae nodos nativos para Ollama o Qdrant — se conectan por su API REST con el nodo genérico HTTP Request, que es justo lo que n8n hace mejor.
Asegurar el acceso
Ninguno de los tres servicios trae autenticación fuerte de serie expuesta a Internet: mantenlos en tu red interna y, si necesitas acceder al editor de n8n desde fuera, hazlo a través de un reverse proxy con autenticación (o de tu VPN/tailnet, no directamente).
Conclusión
Para comprobar que el stack funciona de punta a punta: sube un documento de prueba al flujo de indexado, espera a que aparezca como colección en Qdrant (curl http://localhost:6333/collections), y lanza una pregunta real contra el webhook del flujo de consulta — si la respuesta cita algo que solo está en ese documento, el RAG está funcionando. Vigila la RAM de Ollama: es, con diferencia, el componente que más recursos reales consume de los cuatro.