Un backup que lleva semanas fallando en silencio es indistinguible de uno que funciona — hasta el día que hace falta restaurar. Este stack combina un motor de backup ya cubierto en El Rack (Restic) con un repositorio remoto fuera de tu red y una alerta push inmediata si el trabajo programado falla, se cuelga o simplemente no llega a ejecutarse.
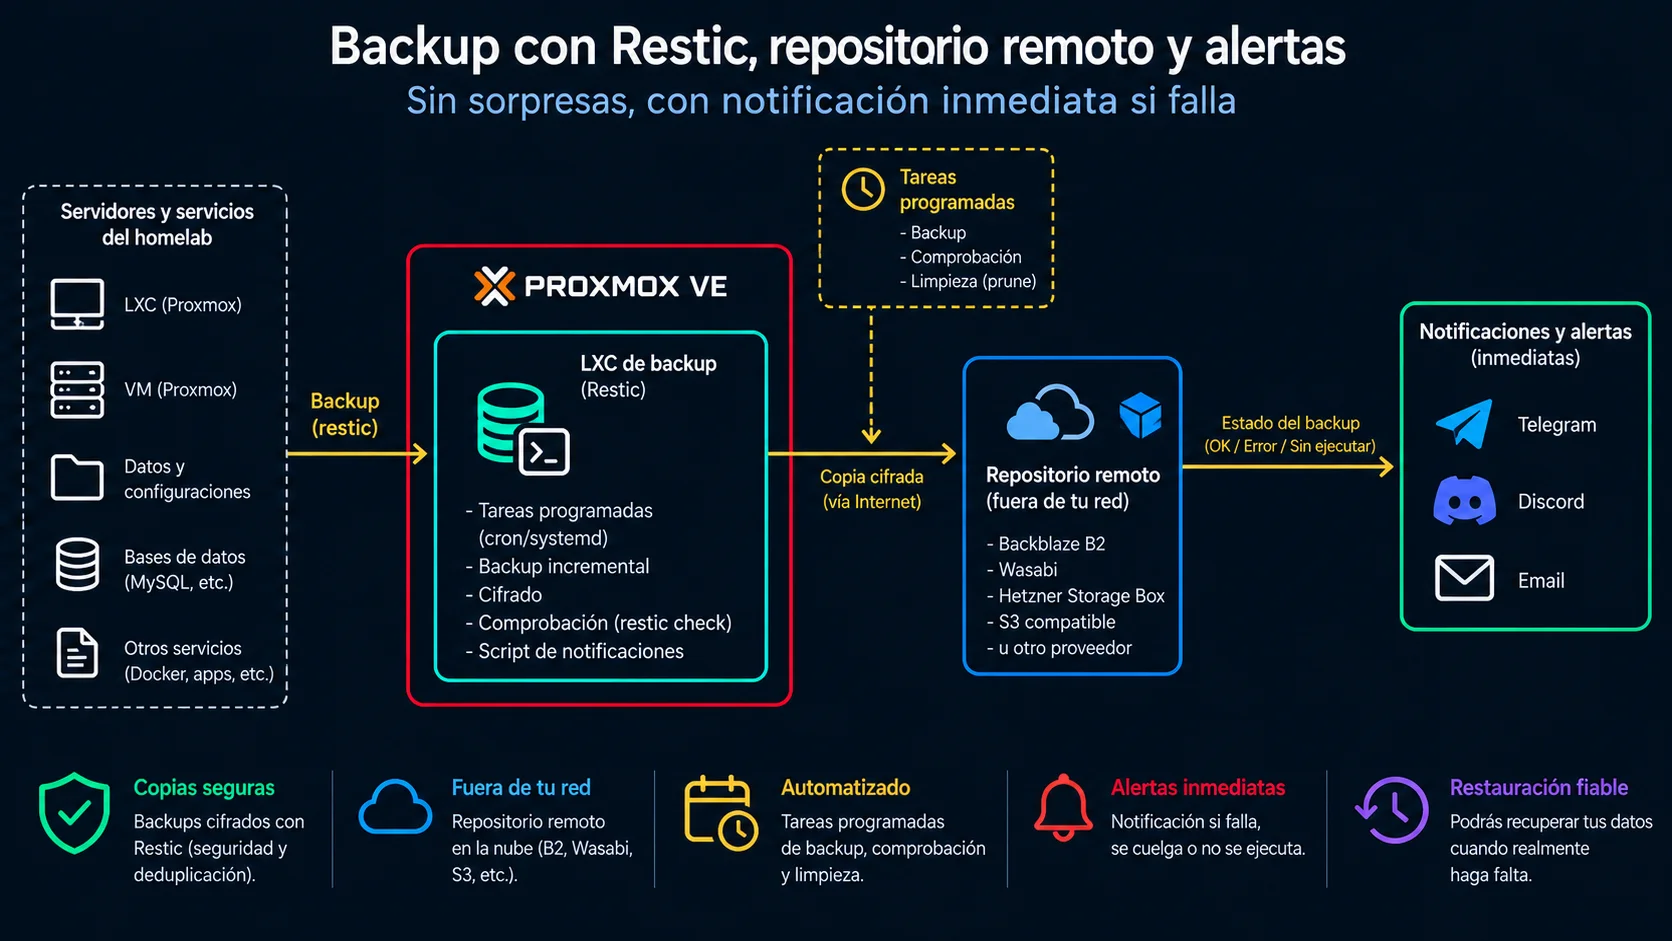
Backups automatizados de tu homelab con aviso si algo falla
Objetivo
Backups 3-2-1 con Restic hacia un repositorio remoto, con una alerta push inmediata si el trabajo programado falla o no llega a ejecutarse.
28 de septiembre de 2026por Sergio Ruiz Navarro
Componentes
Motor de backup (CLI)
ya deberías tenerlo
Repositorio remoto 3-2-1
ya deberías tenerlo
Aviso push si el backup falla
ntfy
128 MB1 vCPU1 GB
Total a reservar (suma de los componentes con recursos propios)
128MB RAM1vCPU1GB disco
Cómo se conecta
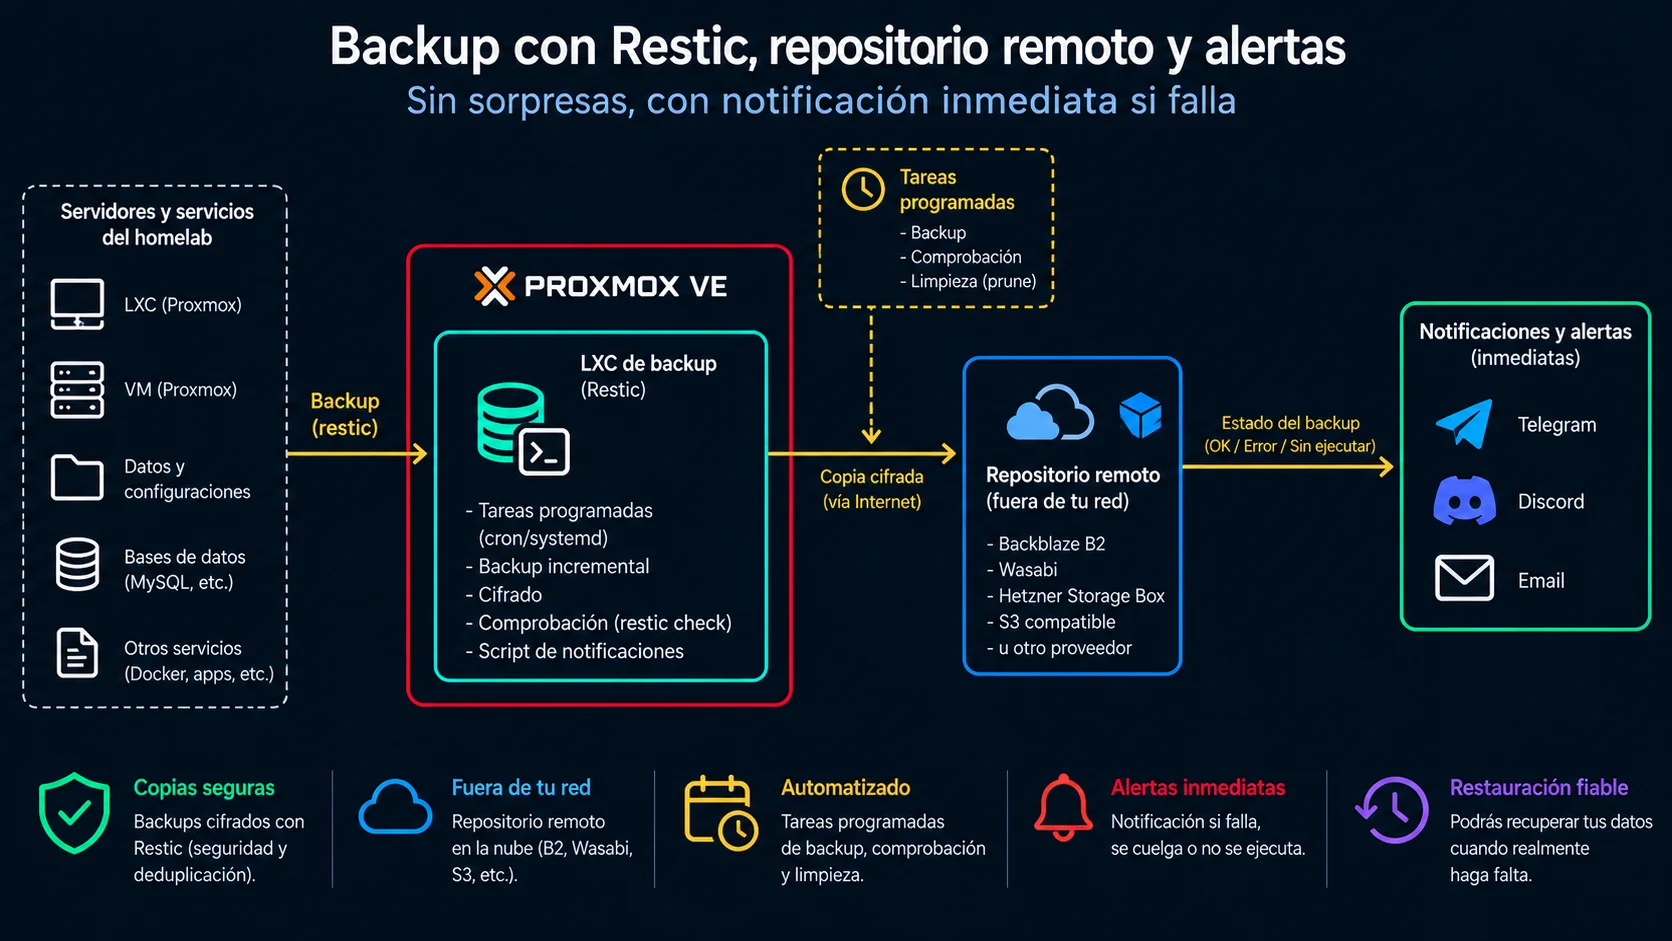
Haz clic para ampliar
Ensamblaje
Preparar el repositorio en Backblaze B2
Crea un bucket privado y una clave de aplicación en el panel de Backblaze. Con las credenciales como variables de entorno, inicializa el repositorio de Restic:
export B2_ACCOUNT_ID="tu_key_id"
export B2_ACCOUNT_KEY="tu_application_key"
restic -r b2:tu-bucket:homelab init
Desplegar ntfy para las alertas
services:
  ntfy:
    image: binwiederhier/ntfy
    container_name: ntfy
    command: serve
    ports:
      - 2586:80
    volumes:
      - ntfy-cache:/var/cache/ntfy
      - ntfy-etc:/etc/ntfy
    restart: unless-stopped
volumes:
  ntfy-cache:
  ntfy-etc:
Suscríbete al topic elegido desde la app móvil de ntfy o desde el navegador, apuntando a tu propia instancia en vez de a ntfy.sh.
Programar el backup con verificación y aviso de fallo
Un script que hace el backup, comprueba la integridad del repositorio con restic check, y avisa por ntfy solo si algo de eso falla:
#!/usr/bin/env bash
set -e
export B2_ACCOUNT_ID="tu_key_id"
export B2_ACCOUNT_KEY="tu_application_key"
REPO="b2:tu-bucket:homelab"
TOPIC="http://localhost:2586/backups-homelab"

if ! restic -r "$REPO" backup /datos --tag diario; then
  curl -H "Title: Backup fallido" -H "Priority: high" -d "El backup diario no se completó" "$TOPIC"
  exit 1
fi

if ! restic -r "$REPO" check; then
  curl -H "Title: Repositorio dañado" -H "Priority: urgent" -d "restic check ha fallado tras el backup" "$TOPIC"
  exit 1
fi
Programar el timer de systemd
# /etc/systemd/system/backup-homelab.service
[Unit]
Description=Backup diario del homelab con Restic

[Service]
Type=oneshot
ExecStart=/usr/local/bin/backup-homelab.sh

# /etc/systemd/system/backup-homelab.timer
[Unit]
Description=Backup diario del homelab

[Timer]
OnCalendar=*-*-* 02:30:00
Persistent=true

[Install]
WantedBy=timers.target
Comprobar que la alerta llega de verdad
Fuerza un fallo controlado (por ejemplo, apunta el script a un bucket que no existe durante la prueba) y confirma que la notificación llega al móvil suscrito al topic antes de dar por bueno el montaje. Un backup con alertas que nunca se han probado es solo un backup con más pasos.
Conclusión
La pieza que de verdad cambia las cosas no es Restic ni Backblaze B2, es el aviso. Sin una alerta que llegue de forma activa, un backup roto es un problema que no descubres hasta que ya es demasiado tarde para arreglarlo sin pérdidas. Compruébalo también al revés: si el timer deja de ejecutarse por completo, la ausencia de la notificación habitual de "todo bien" debería preocuparte tanto como recibir un aviso de fallo.