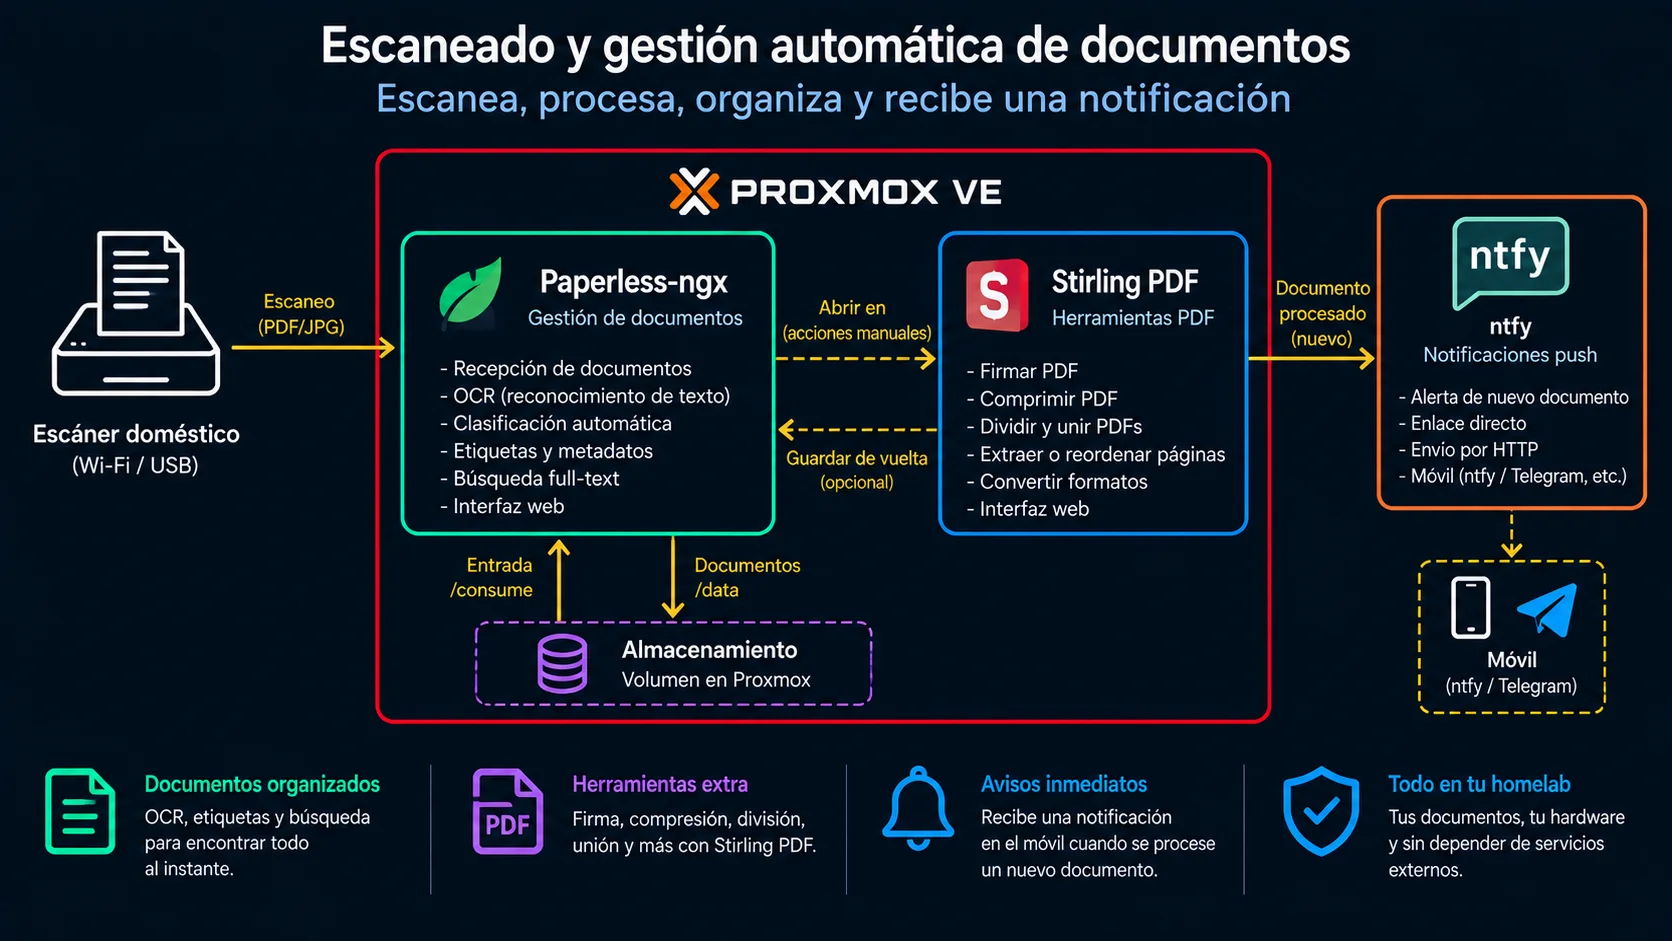
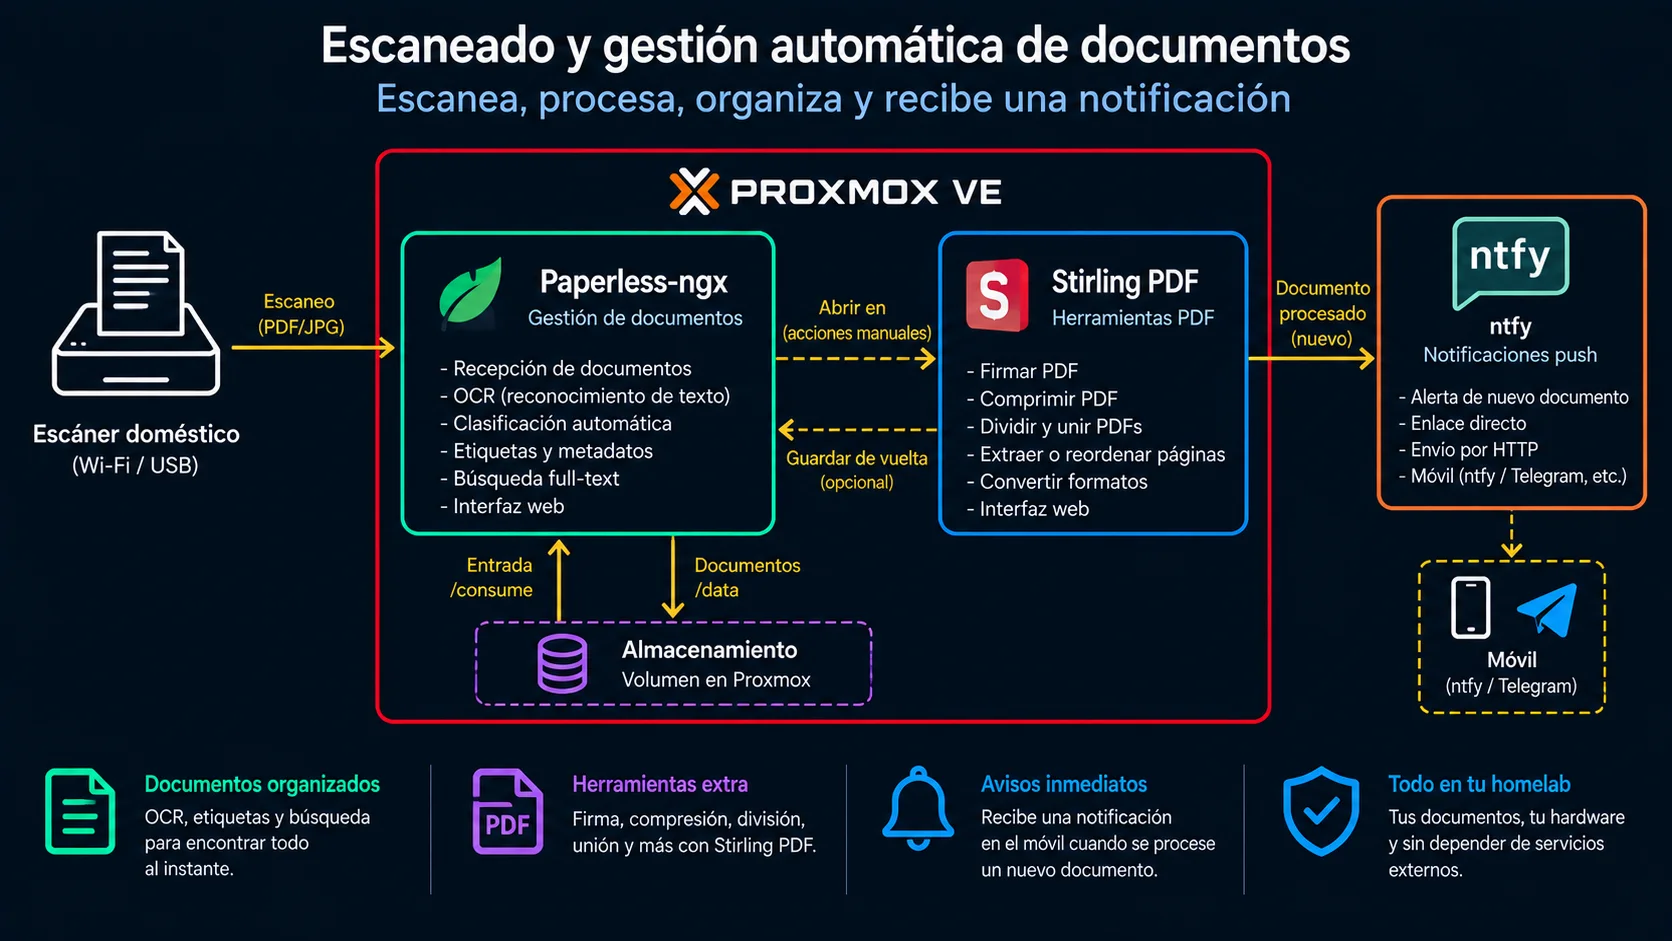
Escanear un documento y que se quede esperando en una carpeta «por organizar» es el destino de casi cualquier escáner doméstico. Este stack lo automatiza entero: Paperless-ngx recibe el documento, le pasa OCR y lo clasifica; Stirling PDF se encarga de lo que Paperless no hace —firmar, comprimir, dividir o unir PDFs sueltos—; y ntfy avisa al móvil en cuanto hay un documento nuevo procesado.
Gestión documental en casa: escanea, organiza con OCR y firma sin la nube
Objetivo
Escanear y digitalizar tus documentos en tu propio servidor, con OCR automático, firma y edición de PDF, y un aviso en el móvil cuando llega uno nuevo.
4 de octubre de 2026por Álvaro Fraguas Bravo
Componentes
Base · host existente
Servidor con Docker
ya deberías tenerlo
Servicio principal · gestión documental y OCR
1 GB2 vCPU20 GB
Base de datos de Paperless-ngx
PostgreSQL
256 MB1 vCPU5 GB
Cola de tareas de OCR en segundo plano
Redis
128 MB1 vCPU1 GB
Firma, compresión y edición de PDF
512 MB1 vCPU2 GB
Aviso cuando llega un documento nuevo
128 MB1 vCPU1 GB
Total a reservar (suma de los componentes con recursos propios)
2GB RAM6vCPU29GB disco
Cómo se conecta
Haz clic para ampliar
Ensamblaje
Levanta el núcleo de Paperless-ngx
Paperless-ngx necesita PostgreSQL para los metadatos y Redis para la cola de tareas de OCR en segundo plano. Levanta los tres como contenedores propios de este stack, sin reutilizar instancias que ya tengas para otra cosa salvo que controles bien los permisos cruzados.
services: broker: image: docker.io/library/redis:7 restart: unless-stopped db: image: docker.io/library/postgres:16 restart: unless-stopped environment: POSTGRES_DB: paperless POSTGRES_USER: paperless POSTGRES_PASSWORD: cambia-esto volumes: - ./pgdata:/var/lib/postgresql/data webserver: image: ghcr.io/paperless-ngx/paperless-ngx:latest restart: unless-stopped depends_on: - db - broker ports: - "8010:8000" environment: PAPERLESS_REDIS: redis://broker:6379 PAPERLESS_DBHOST: db PAPERLESS_OCR_LANGUAGE: spa PAPERLESS_SECRET_KEY: cambia-esto-tambien volumes: - ./consume:/usr/src/paperless/consume - ./media:/usr/src/paperless/media - ./data:/usr/src/paperless/dataConfigura la carpeta de consumo
Monta una carpeta compartida (SMB, NFS, o simplemente la carpeta donde vuelca tu escáner) como el volumen
consumedel contenedor. Cualquier PDF o imagen que caiga ahí entra automáticamente en la cola de OCR y clasificación, sin que tengas que subirlo a mano desde la interfaz web.Añade Stirling PDF para lo que Paperless no cubre
  stirling-pdf:
    image: docker.io/stirlingtools/stirling-pdf:latest
    restart: unless-stopped
    ports:
      - "8011:8080"
    volumes:
      - ./stirling-data:/usr/share/tessdata
      - ./stirling-config:/configs
Paperless-ngx organiza y busca, pero no firma ni edita PDFs sueltos. Stirling PDF cubre justo eso: firmar, comprimir, dividir o unir documentos antes (o después) de que entren en el archivo definitivo.
Conecta ntfy para el aviso
  ntfy:
    image: docker.io/binwiederhier/ntfy:latest
    command: serve
    restart: unless-stopped
    ports:
      - "8012:80"
    volumes:
      - ./ntfy-cache:/var/cache/ntfy
Paperless-ngx permite definir workflows que, tras consumir un documento, ejecutan un script. Ese script solo necesita una llamada a ntfy para avisar.
#!/bin/sh
# post-consumo: avisa por ntfy del documento recién procesado
curl -s -d "Nuevo documento: ${DOCUMENT_FILE_NAME}" http://ntfy:80/paperless
Conclusión
Para comprobar que todo encaja, deja caer un PDF cualquiera en la carpeta de consumo: en menos de un minuto debería aparecer ya indexado y con OCR en Paperless-ngx, con un aviso de ntfy en el móvil. Si necesitas firmarlo o juntarlo con otro antes de archivarlo, Stirling PDF está a un enlace de distancia sin salir del mismo servidor.