Cuando un homelab crece más allá de dos o tres servicios, la pregunta deja de ser "¿funciona?" y pasa a ser "¿por qué ha dejado de funcionar, y desde cuándo?". Este stack junta tres piezas independientes — métricas, logs y comprobación de disponibilidad — en un único panel, sin montar una plataforma de observabilidad de nivel empresa que nadie en un homelab necesita de verdad.
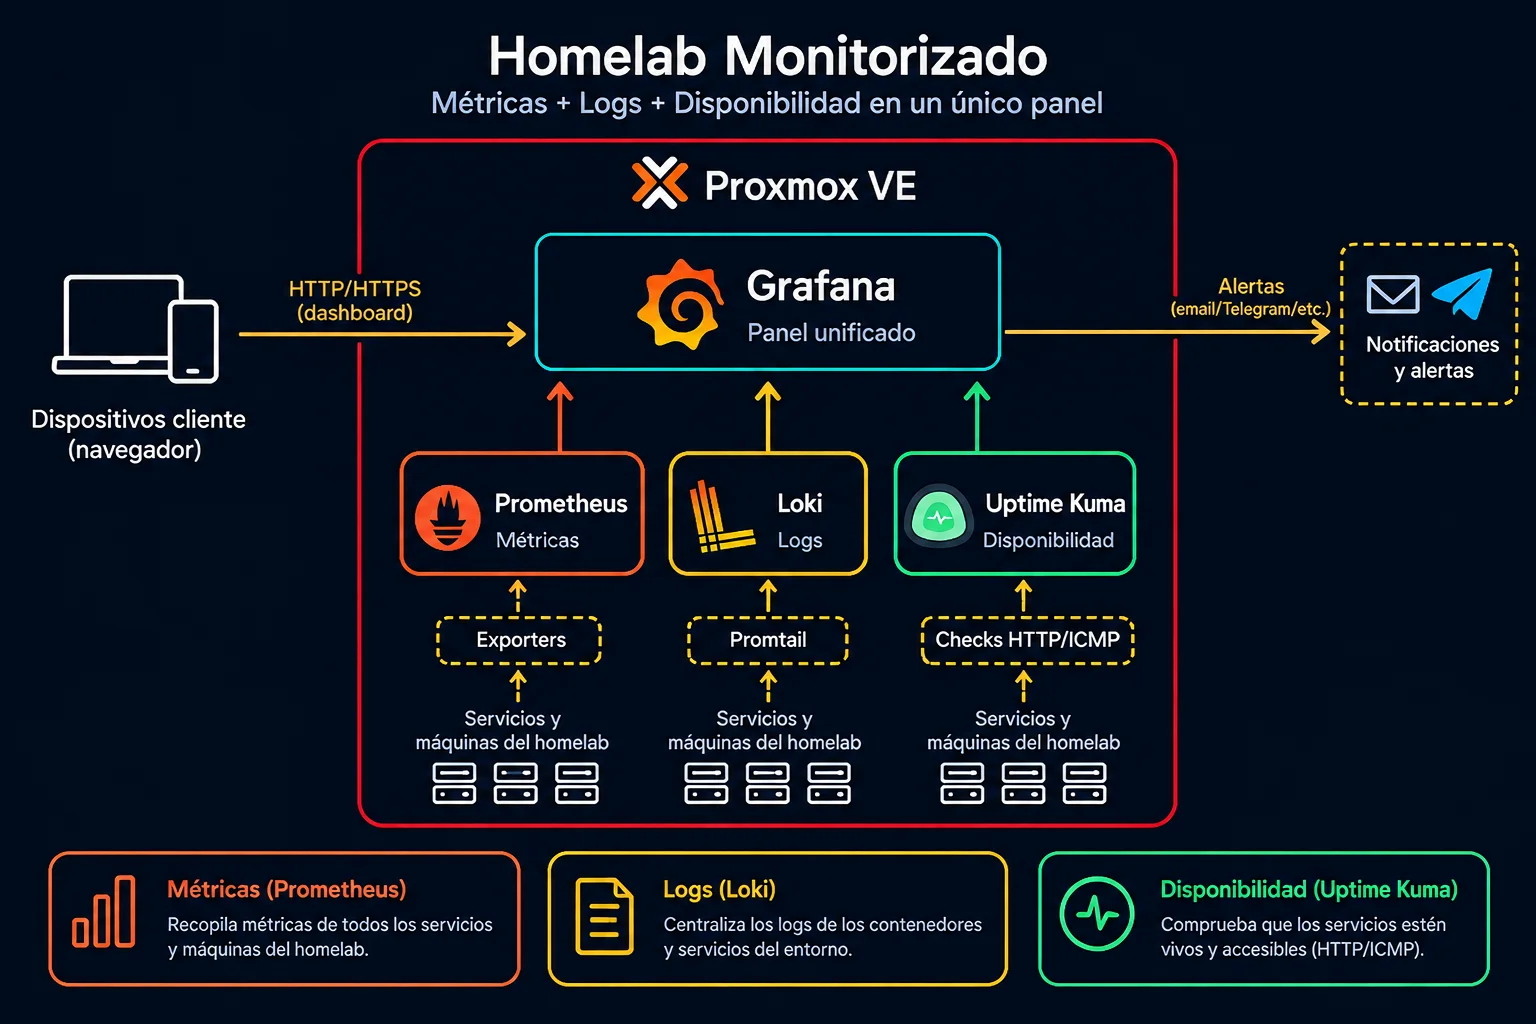
Observabilidad completa: métricas, logs y disponibilidad en un panel único
Objetivo
Centralizar en un solo stack las métricas de tus hosts y contenedores, sus logs, y la comprobación de disponibilidad de tus servicios, con un panel único en Grafana.
26 de septiembre de 2026por Álvaro Fraguas Bravo
Componentes
Base · host Docker
Servidor Docker existente
ya deberías tenerlo
Panel de dashboards y agregación de logs
3 GB2 vCPU25 GB
Recolección de métricas de hosts y contenedores
1 GB1 vCPU10 GB
Comprobación de disponibilidad y página de estado
512 MB1 vCPU1 GB
Total a reservar (suma de los componentes con recursos propios)
4.5GB RAM4vCPU36GB disco
Cómo se conecta
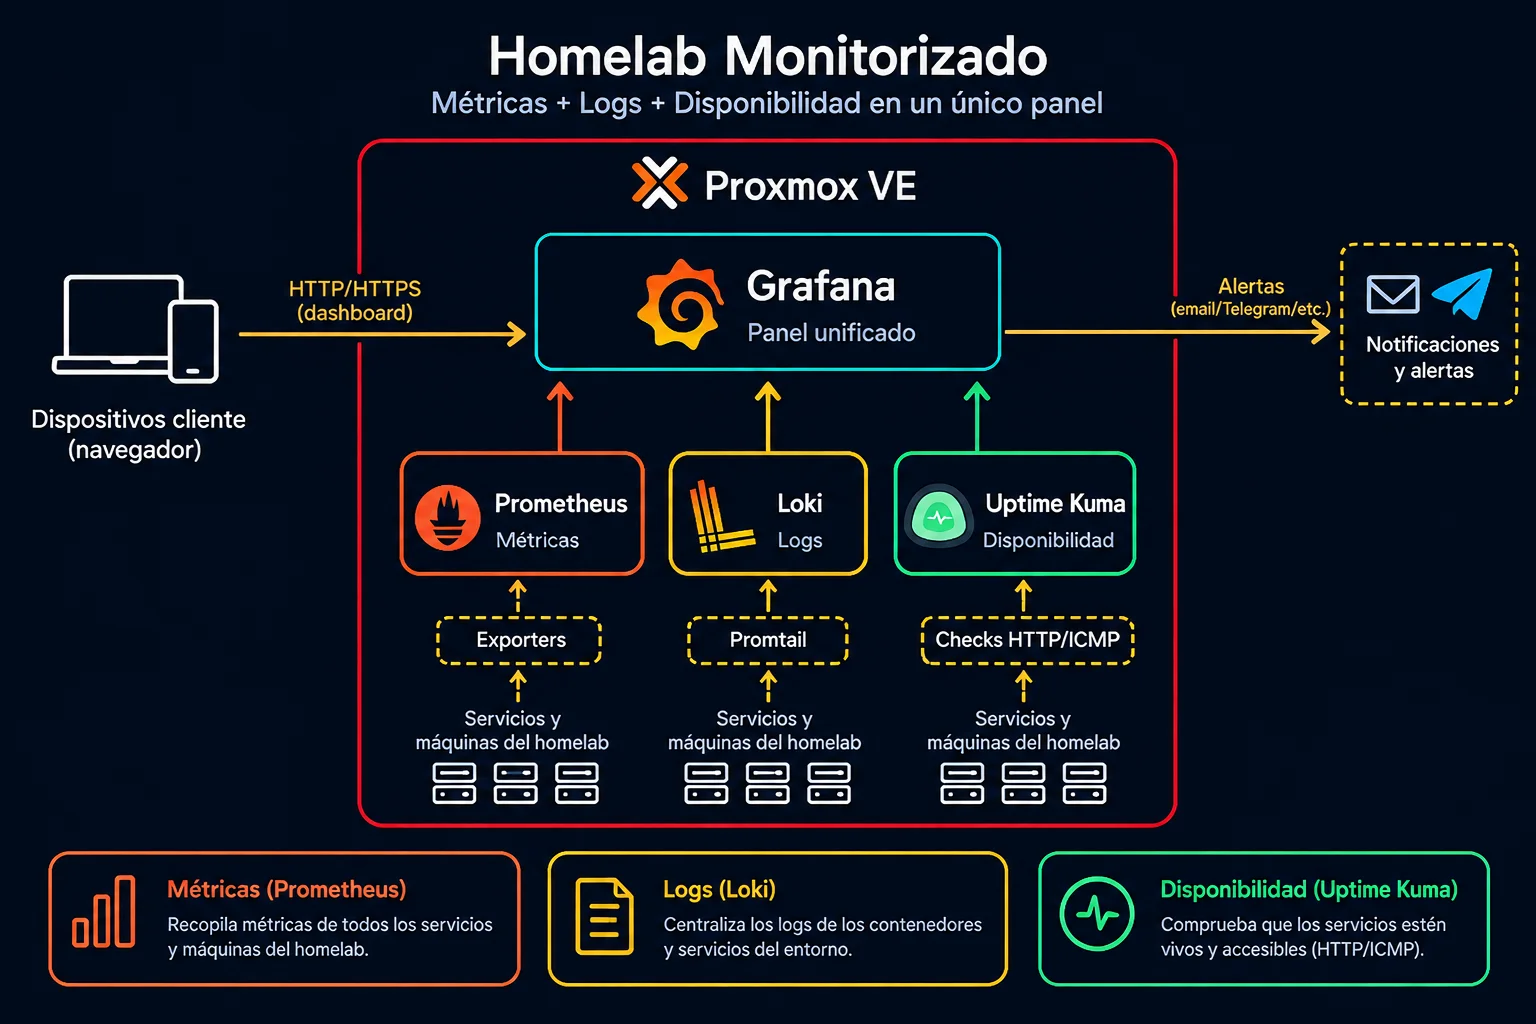
Haz clic para ampliar
Ensamblaje
Antes de empezar
Necesitas un host con Docker y Docker Compose, y acceso de red desde ese host a los demás servicios que quieras monitorizar. Los recursos de la tabla de componentes son por pieza — puedes arrancarlas todas en el mismo host para un homelab pequeño, o repartirlas si ya tienes varios.
Desplegar Prometheus y los exporters
Prometheus recoge métricas activamente (scraping) desde cada host y contenedor. En cada máquina a monitorizar, despliega node_exporter (métricas de sistema) y, si usas contenedores, cAdvisor (métricas por contenedor). Un docker-compose.yml mínimo para Prometheus:
services: prometheus: image: prom/prometheus:latest volumes: - ./prometheus.yml:/etc/prometheus/prometheus.yml - prometheus-data:/prometheus ports: - "9090:9090" volumes: prometheus-data:Desplegar Loki en modo monolítico
Para un homelab, el modo monolítico de Loki (todo en un único proceso, sin separar ingesta y consulta) es suficiente:
services: loki: image: grafana/loki:latest ports: - "3100:3100" volumes: - loki-data:/loki volumes: loki-data:Enviar los logs de tus contenedores a Loki
Usa Grafana Alloy como agente recolector en cada host — es el sustituto oficial de Promtail (retirado en marzo de 2026) para este mismo propósito. Alloy lee los logs de Docker y los envía a Loki con las etiquetas de host y contenedor ya puestas, lo que luego permite filtrar por ambas en Grafana.
Desplegar Grafana y conectar las dos fuentes
Añade Prometheus y Loki como data sources en Grafana (Configuration > Data Sources), apuntando a sus URLs internas (http://prometheus:9090 y http://loki:3100 si comparten red Docker).
Montar el dashboard
Importa un dashboard existente para node_exporter/cAdvisor (hay varios en el catálogo público de Grafana) como punto de partida, y añade un panel de logs de Loki filtrado por contenedor junto a los paneles de métricas — la correlación por tiempo entre ambos es la parte que de verdad ahorra tiempo al depurar un incidente.
Desplegar Uptime Kuma y dar de alta los primeros monitores
Uptime Kuma vive independiente del resto del stack, a propósito: si Grafana o Prometheus se caen, quieres que algo externo siga avisando. Da de alta un monitor HTTP(S) por cada servicio público y uno TCP para los que no exponen web.
docker run -d --restart unless-stopped -p 3001:3001 -v uptime-kuma-data:/app/data --name uptime-kuma louislam/uptime-kuma:1
Centralizar notificaciones
Configura el mismo canal de notificación (Telegram, Discord, email) tanto en las alertas de Prometheus como en Uptime Kuma, para no tener que vigilar dos sitios distintos cuando algo se cae.
Conclusión
Con esto tienes en un mismo panel de Grafana las métricas de CPU/RAM/disco de cada host, los logs de todos los contenedores correlacionados por etiqueta, y un histórico de disponibilidad independiente vía Uptime Kuma. Para comprobar que todo encaja: fuerza la caída de un contenedor de prueba y confirma que aparece tanto en el dashboard de métricas (uso de CPU a cero) como en el log de Loki (el evento de parada) y como una alerta en Uptime Kuma — si los tres lo detectan, el stack está correctamente conectado.