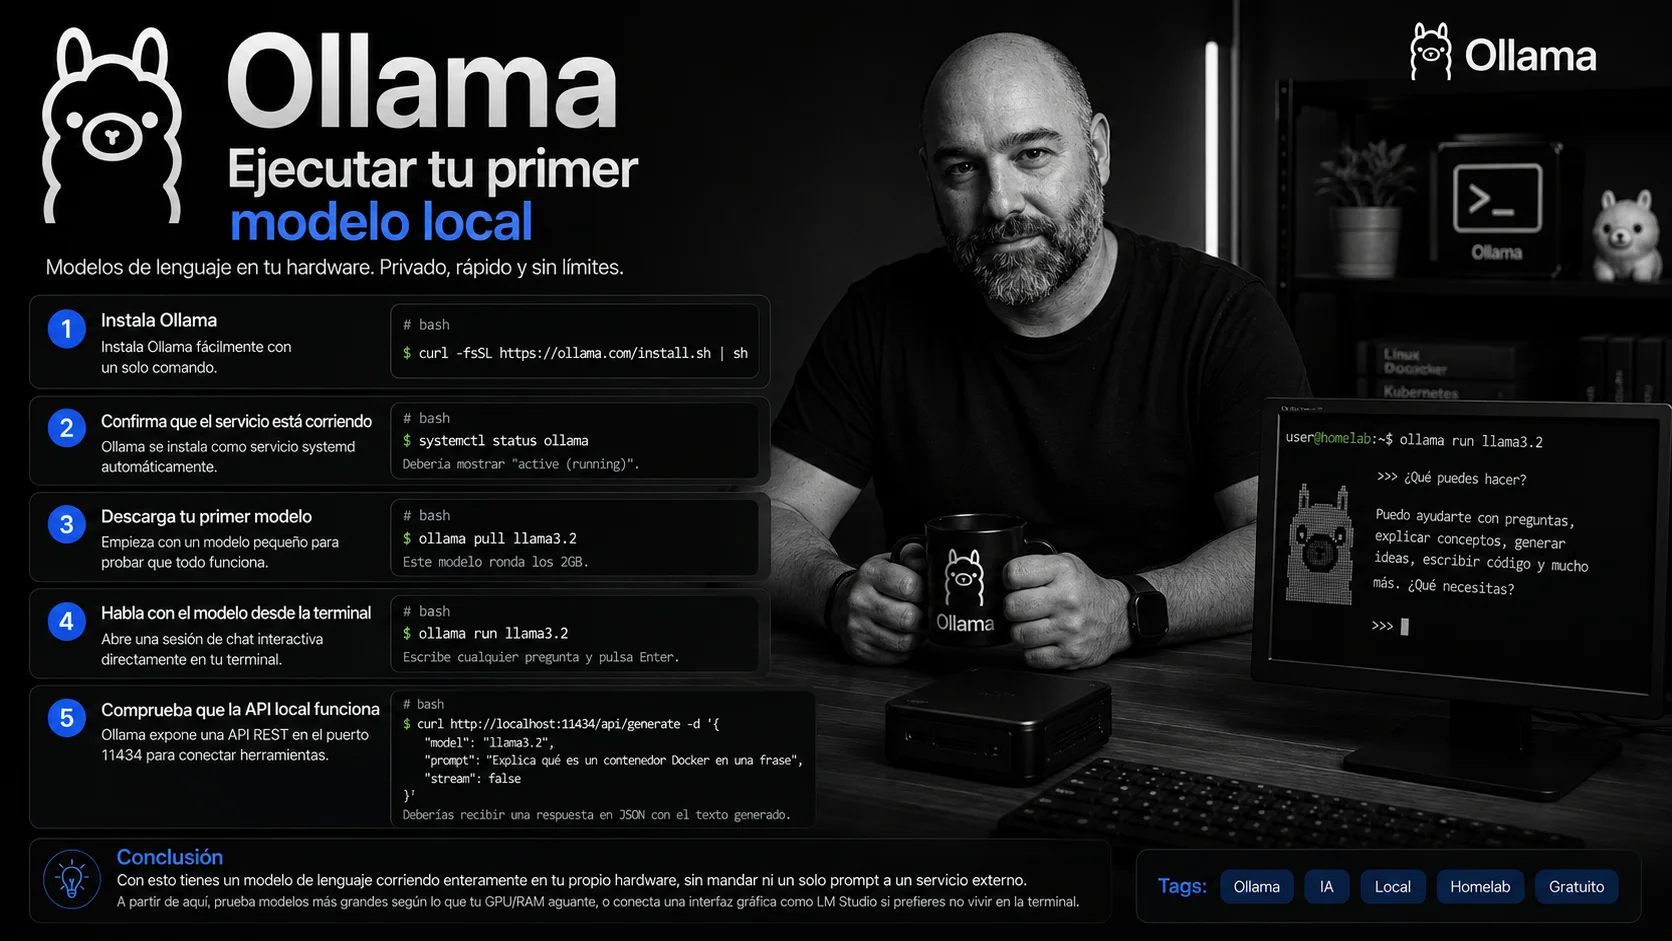
Cómo instalar Ollama y ejecutar tu primer modelo local
- 1
Paso 1: Instala Ollama
curl -fsSL https://ollama.com/install.sh | sh - 2
Paso 2: Confirma que el servicio está corriendo
systemctl status ollamaDebería mostrar «active (running)» — Ollama se instala como servicio systemd automáticamente.
- 3
Paso 3: Descarga tu primer modelo
Empieza con un modelo pequeño para probar que todo funciona antes de descargar algo más pesado.
ollama pull llama3.2El tamaño de descarga varía según el modelo — este ronda los 2GB.
- 4
Paso 4: Habla con el modelo desde la terminal
ollama run llama3.2Esto abre una sesión de chat interactiva directamente en tu terminal. Escribe cualquier pregunta y pulsa Enter.
- 5
Paso 5: Comprueba que la API local funciona
Ollama expone una API REST en el puerto 11434, que es lo que usan herramientas como LM Studio o tus propios scripts para conectarse.
curl http://localhost:11434/api/generate -d '{
  "model": "llama3.2",
  "prompt": "Explica qué es un contenedor Docker en una frase",
  "stream": false
}'
Si recibes una respuesta en JSON con el texto generado, la API está funcionando correctamente y ya puedes conectar cualquier herramienta compatible.
Conclusión
Con esto tienes un modelo de lenguaje corriendo enteramente en tu propio hardware, sin mandar ni un solo prompt a un servicio externo. A partir de aquí, prueba modelos más grandes según lo que tu GPU/RAM aguante, o conecta una interfaz gráfica como LM Studio si prefieres no vivir en la terminal.