Un preview de Qwen4 que llega presumiendo de benchmarks, no solo de precio
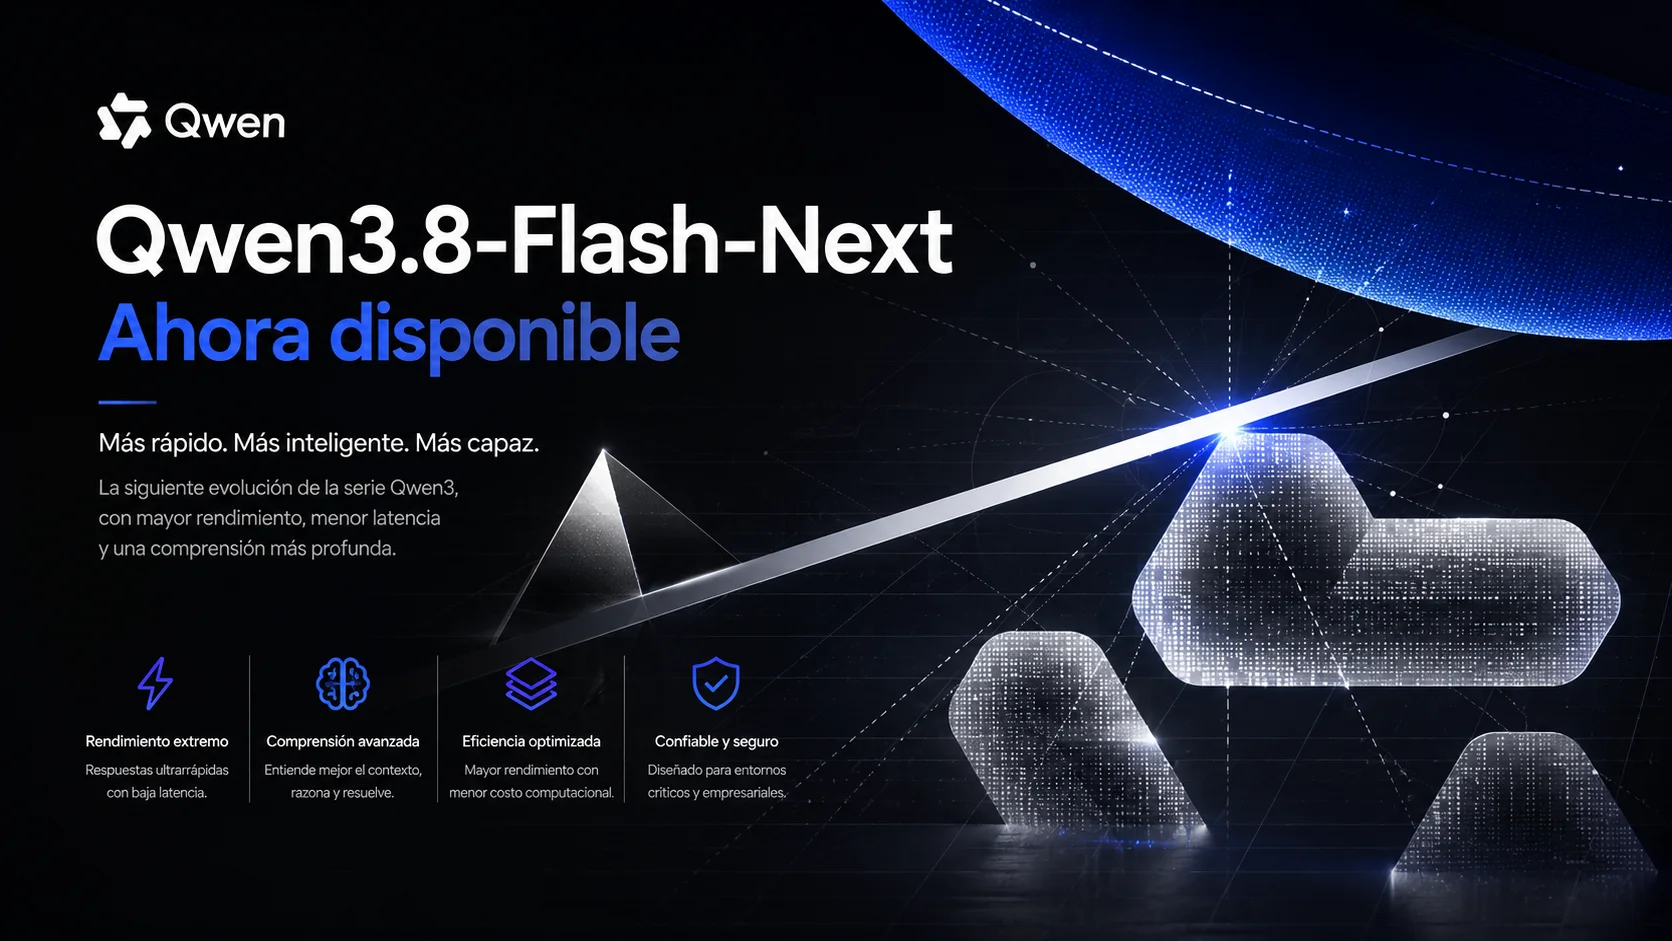
Alibaba publicó el 26 de agosto de 2026 Qwen3.8-Flash-Next, un modelo de pesos abiertos que la propia compañía presenta como preview de su próxima arquitectura Qwen4. La cifra que más llama la atención no es la de parámetros -- 125.000 millones totales, con solo 6.000 millones activos por token en su diseño MoE disperso -- sino la de coste de entrenamiento: según Alibaba, aproximadamente una novena parte de lo que costó entrenar el modelo anterior de la familia, Qwen3.7-Plus, con mejor rendimiento en varios benchmarks de código y trabajo agéntico.
Que un modelo con solo 6.000 millones de parámetros activos por token reivindique superar a Claude Opus 4.6 Max en SWE-bench Pro (62,5 frente a 53,4) y JobBench (55,7 frente a 36,6) es, si se confirma con evaluación independiente, una declaración fuerte sobre hacia dónde va la eficiencia de arquitectura en modelos abiertos -- pero conviene recordar que esas cifras, por ahora, solo vienen de quien tiene todo el interés en que el modelo quede bien posicionado.
El precio y el contexto, la parte más fácil de verificar
Vía QwenCloud, el modelo se ofrece como qwen3.8-flash a 0,16$ por millón de tokens de entrada y 0,47$ por millón de salida, con lectura de caché a 0,016$ por millón -- cifras que lo colocan entre los modelos más baratos del mercado con esta capacidad declarada. El contexto nativo de 1.048.576 tokens, con mejoras de hasta 8,6x en throughput de prefill frente a Qwen3.7-Plus en contextos de un millón de tokens, es relevante sobre todo para flujos de trabajo agénticos que necesiten procesar documentación extensa o historiales largos de conversación sin trocear la entrada.
Lo que hay que tratar con cautela: los benchmarks propios
El patrón de benchmarks elegidos por el propio fabricante para posicionar un modelo frente a la competencia no es nuevo, y no invalida por sí solo el resultado -- pero sí exige el mismo escepticismo de siempre: SWE-bench Pro, CoWorkBench y JobBench son evaluaciones reales y conocidas en la industria, no inventadas para la ocasión, pero la elección de cuáles mostrar y frente a qué modelo comparar corresponde a Alibaba, no a un tercero neutral. Hasta que aparezcan evaluaciones independientes que repliquen estos resultados, la cifra concreta de "supera a Opus 4.6 Max" debería leerse como la reivindicación de Alibaba, no como un hecho establecido.
Pesos abiertos, pero con matices de acceso real
A diferencia de otras variantes recientes de la competencia que solo se ofrecen como servicio, Qwen3.8-Flash-Next sí publica pesos descargables -- en teoría, cualquiera con el hardware adecuado puede autoalojarlo. En la práctica, un modelo de 125.000 millones de parámetros totales, aunque disperso y con solo 6.000 millones activos por token, sigue exigiendo GPU e infraestructura fuera del alcance de un homelab medio. Para la inmensa mayoría de quien lea esta review, la vía real de acceso seguirá siendo la API de pago, con el self-hosting como opción teórica más que práctica.
¿Para quién es esto?
Para quien ya evalúe modelos abiertos chinos por precio y capacidad agéntica (la comparación natural es con DeepSeek V4 Flash), Qwen3.8-Flash-Next merece una prueba propia dado lo agresivo del precio y lo prometedor -- con matices -- de sus cifras de benchmark. Para quien necesite un modelo con historial de producción largo y benchmarks verificados de forma independiente, conviene esperar a que la comunidad replique estos resultados antes de construir algo crítico encima.