Montar Grafana más Prometheus para ver el estado de un solo servidor es llevar un camión para mover una caja. Netdata resuelve el caso más habitual —«¿qué está pasando en esta máquina ahora mismo?»— con un agente que se instala en un comando, detecta solo todo lo que hay (discos, red, contenedores Docker, bases de datos, lo que sea) y pinta métricas por segundo sin escribir una sola línea de configuración.
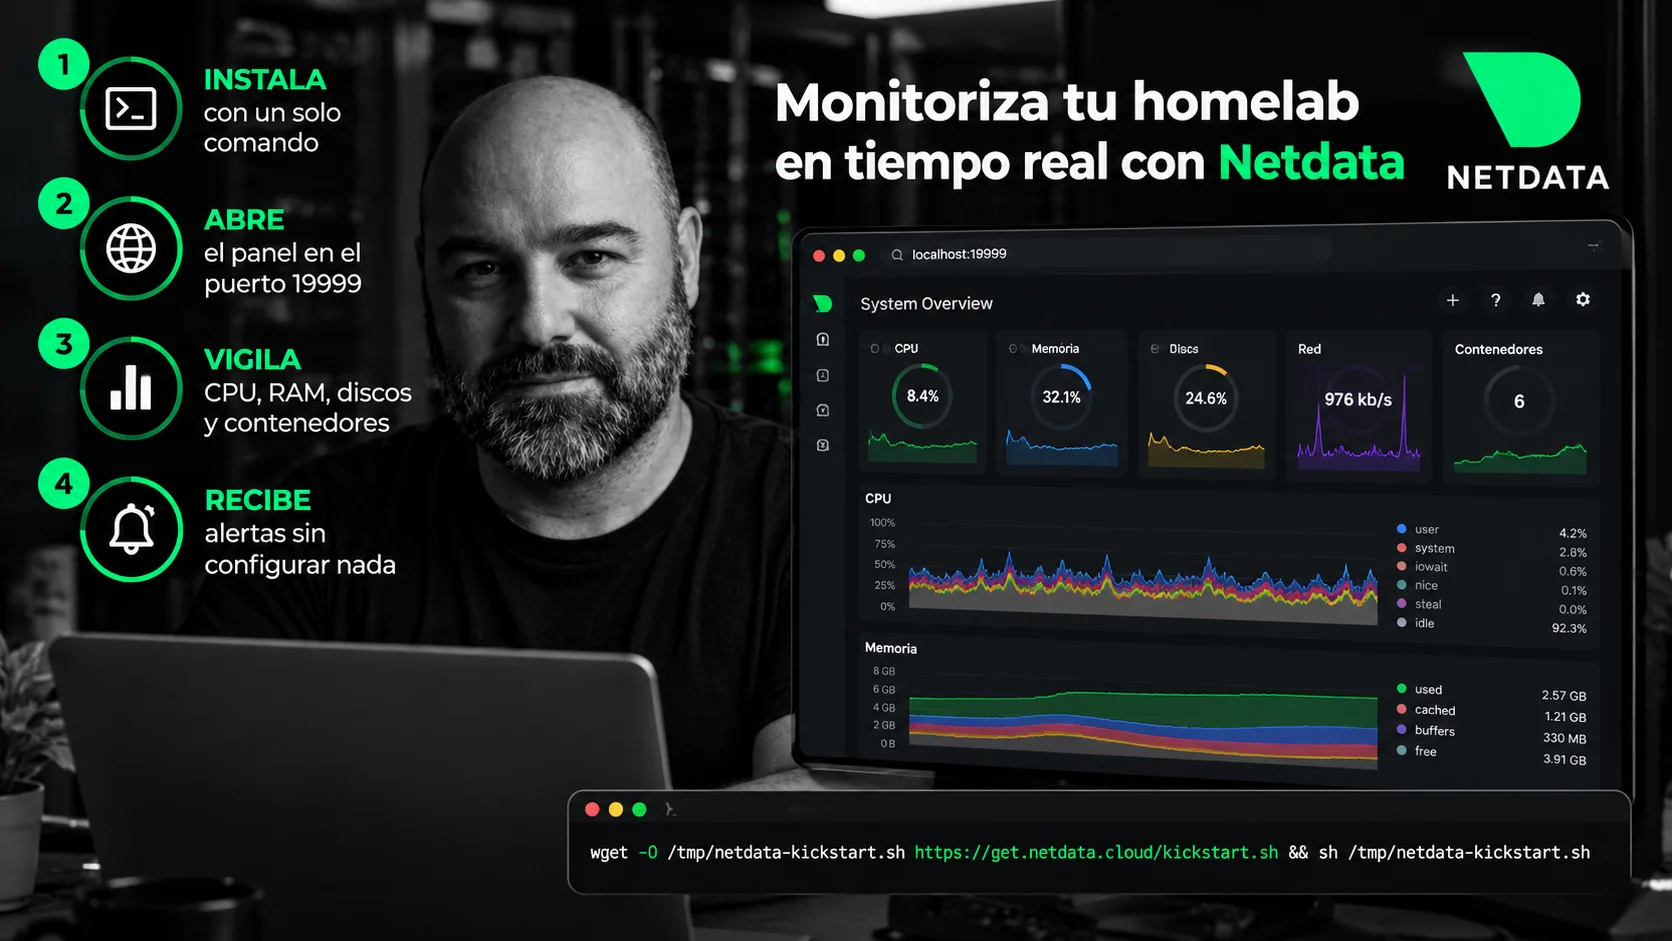
Cómo instalar Netdata para ver el estado de tu homelab en tiempo real, sin tocar un solo YAML
4 de octubre de 2026por Álvaro Fraguas Bravo
- 1
Paso 1: Instala el agente
wget -O /tmp/netdata-kickstart.sh https://get.netdata.cloud/kickstart.sh
sh /tmp/netdata-kickstart.sh
El script detecta la distro, instala las dependencias y arranca el servicio. No hace falta Docker si prefieres el agente nativo; también existe la imagen oficial
netdata/netdatapara quien ya lo despliega todo en contenedores. - 2
Paso 2: Accede al panel local
Por defecto escucha en el puerto 19999 de la propia máquina (
http://<ip-del-servidor>:19999), sin usuario ni contraseña — pensado para quedarse detrás de tu propia red o de un reverse proxy con autenticación propia, no para exponerlo tal cual a Internet. - 3
Paso 3: Revisa qué ha detectado solo
Netdata detecta automáticamente servicios en marcha (contenedores Docker, bases de datos locales como MySQL o PostgreSQL, sensores de temperatura y disco) y activa comprobaciones de salud con umbrales razonables de fábrica — no hace falta definir ninguna alerta a mano para empezar a recibir avisos cuando algo se sale de lo normal.
- 4
Paso 4: Agrupa varias máquinas en un único panel (opcional)
Si tienes más de una máquina, un nodo Netdata «Parent» autoalojado (sin depender de Netdata Cloud) agrupa varios agentes en un único panel y centraliza su almacenamiento — útil en cuanto el homelab pasa de una máquina a tres o cuatro.
Conclusión
En pocos minutos tienes métricas por segundo de todo lo que corre en la máquina, con alertas razonables activadas de fábrica. No sustituye a Grafana más Prometheus si ya tienes un stack de observabilidad con retención larga y dashboards a medida, pero para saber qué le pasa a un servidor concreto ahora mismo es más rápido que montar cualquier alternativa.